문제 상황
텍스트 파일을 읽어 쉼표 단위로 문자열을 나누면 데이터 내부에 쉼표가 있을 때 열이 잘못 나뉩니다. 주소나 설명 문구에 쉼표나 줄바꿈이 포함된 CSV 데이터는 단순 분할 방식으로는 다루기 어렵습니다. 예외 상황을 일일이 조건문으로 처리하지 않고 안정하게 데이터를 입출력하는 방법이 필요합니다.
해결 코드
import csv

path = "sample.csv"
fields = ["name", "age", "city"]
data = [
    {"name": "김철수", "age": "30", "city": "서울, 대한민국"},
    {"name": "이영희", "age": "25", "city": "부산"},
]

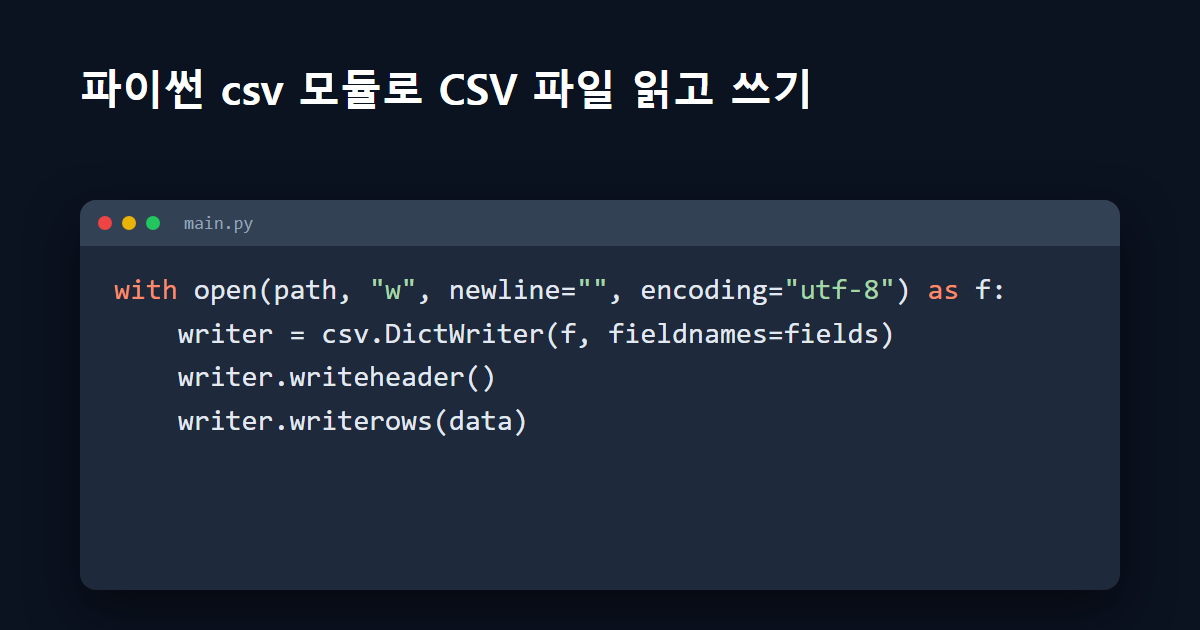
with open(path, "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=fields)
    writer.writeheader()
    writer.writerows(data)

with open(path, "r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        print(f"{row['name']} / {row['age']} / {row['city']}")
코드 설명
- 파이썬 표준 라이브러리에 포함된 csv 모듈을 불러옵니다.
- 파일 경로와 헤더 목록 및 딕셔너리 형태의 대상 데이터를 정의합니다.
- DictWriter 객체를 통해 파일에 헤더와 전체 데이터 행을 순서대로 작성합니다.
- newline 옵션에 빈 문자열을 전달하여 행 사이에 불필요한 빈 줄이 추가되지 않습니다.
- 작성된 파일을 DictReader 객체로 읽어 각 행을 딕셔너리 형태로 변환하고 출력합니다.
실행 결과
출력 결과를 보면 ‘서울, 대한민국’처럼 값 내부에 쉼표가 들어간 데이터도 독립된 하나의 열로 처리되어 ‘김철수 / 30 / 서울, 대한민국’ 행으로 출력됩니다.
김철수 / 30 / 서울, 대한민국
이영희 / 25 / 부산
정리
- 문자열 분할 방식 대신 csv 모듈을 사용하면 쉼표가 들어간 값도 올바르게 분리됩니다.
- DictWriter와 DictReader를 사용하면 데이터가 딕셔너리 구조로 매핑되어 열 접근이 쉬워집니다.
- open 함수 호출 시 newline=”” 옵션을 주면 플랫폼별 줄바꿈 차이로 인한 빈 줄이 생성되지 않습니다.
- encoding=”utf-8″ 옵션을 지정하여 한글 데이터가 깨지지 않고 그대로 저장됩니다.
답글 남기기